Agente de voz no atendimento: como funciona e o que faz um bom projeto
As arquiteturas de um agente de voz, por que a latência decide a experiência, como lidar com turnos, interrupções, telefonia e português falado, e como medir se o agente está resolvendo.
Um agente de voz é um agente de IA que atende por telefone ou por áudio: escuta o cliente, entende o pedido, consulta e age nos sistemas da empresa e responde falando. Na URA tradicional, o cliente escolhe opções num menu ou diz palavras-chave. O agente de voz conversa em linguagem natural, do jeito que o cliente fala.
Colocar um agente de voz em produção é mais difícil do que um agente de texto. Além do modelo de linguagem e do harness, entram reconhecimento e síntese de fala, controle de turnos de conversa, telefonia e o português falado, com sotaque, ruído e números ditados. Este guia mostra como cada parte funciona e o que separa um agente de voz que resolve de um que irrita o cliente.
As duas arquiteturas de um agente de voz
Existem dois jeitos de montar um agente de voz:
- Encadeada: três etapas em sequência. O reconhecimento de fala (STT) transcreve o que o cliente disse, o modelo de linguagem decide o que fazer e escreve a resposta, e a síntese de voz (TTS) transforma o texto em fala.
- Fala a fala: um único modelo recebe o áudio, entende, decide e já responde em áudio, sem passar por texto no meio.
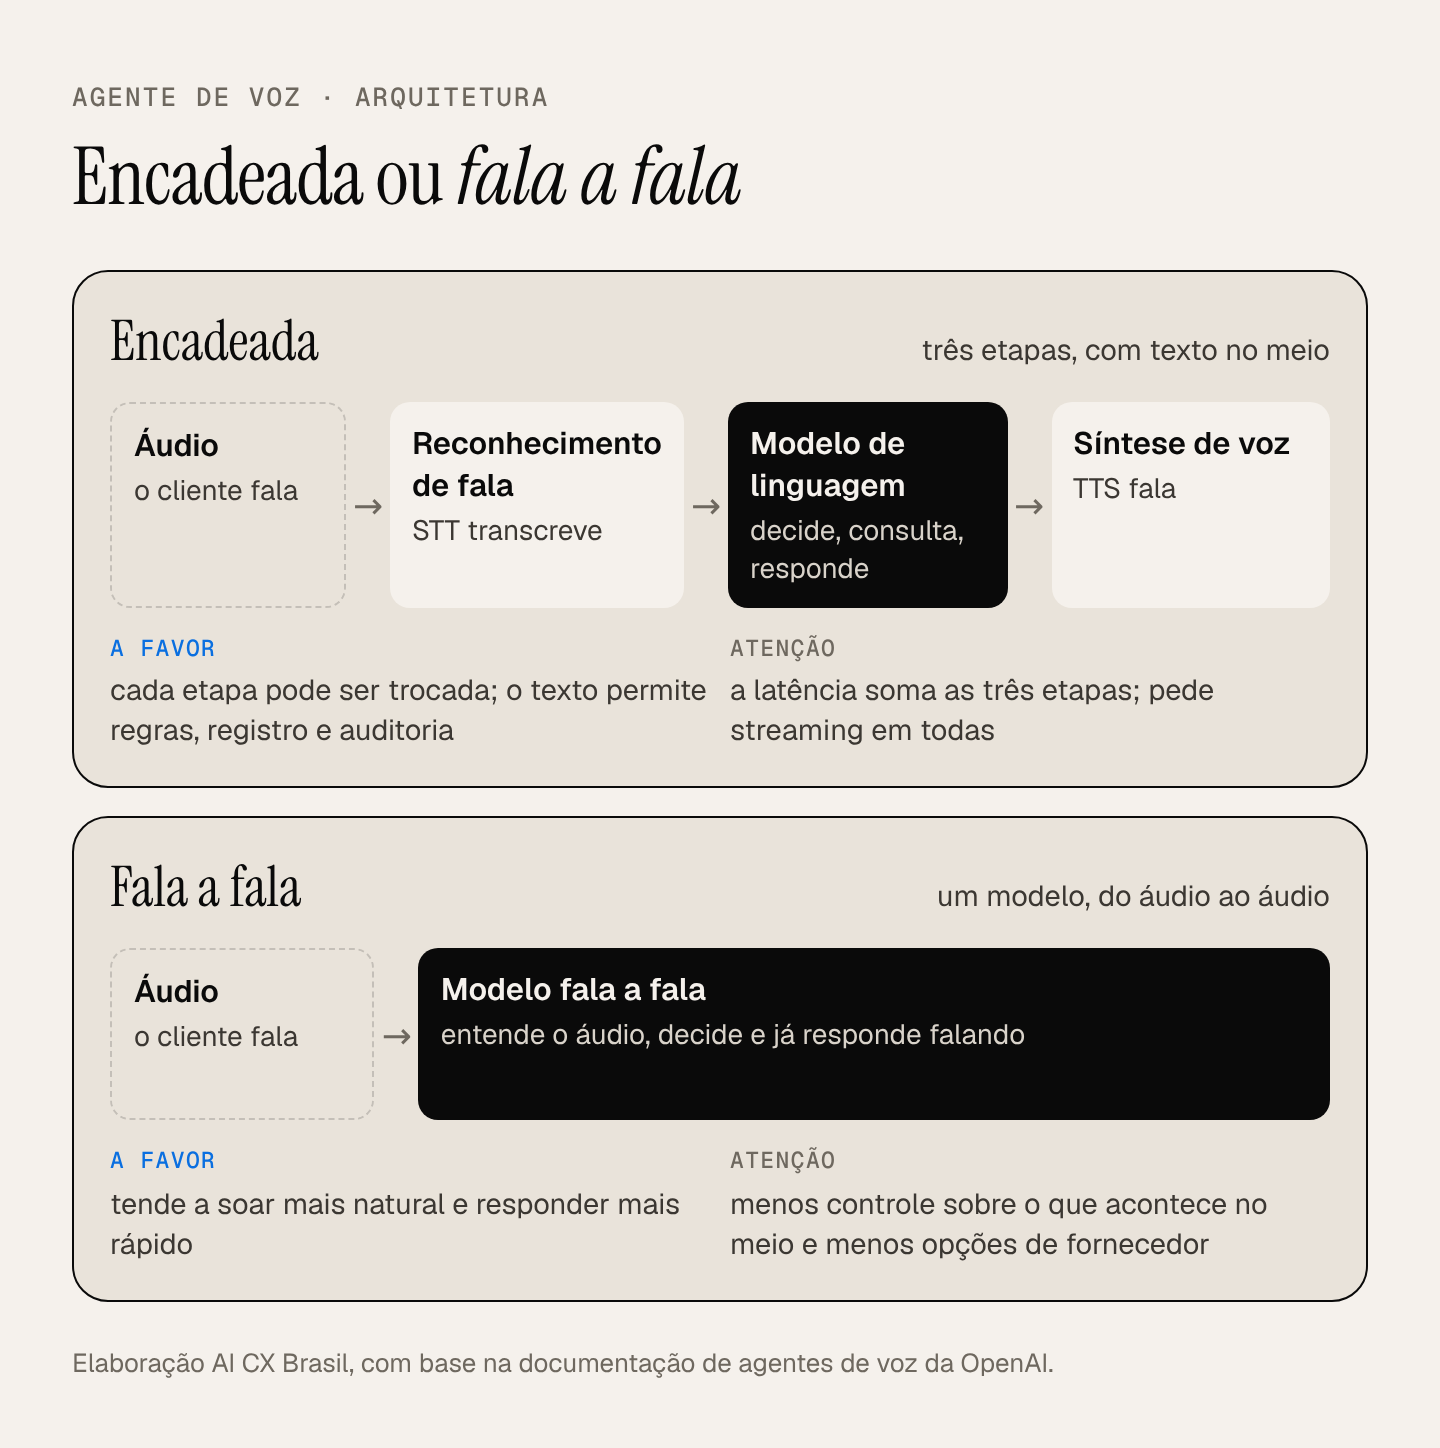
A documentação da OpenAI para agentes de voz recomenda o caminho encadeado quando a empresa quer inspecionar ou transformar o texto entre as etapas e trocar cada componente de forma independente. No atendimento, isso pesa: o texto intermediário permite aplicar regras, registrar a conversa, auditar o que o agente disse e escolher o melhor fornecedor para cada etapa. O modelo fala a fala tende a soar mais natural e a responder mais rápido, mas dá menos controle sobre o que acontece no meio.
Na prática, muitas operações combinam as duas coisas: um pipeline encadeado em que cada etapa trabalha em fluxo contínuo (streaming), sem esperar a anterior terminar por completo.
Latência: o tempo que o cliente percebe
Latência é o tempo entre o cliente parar de falar e o agente começar a responder. Numa conversa entre pessoas, o silêncio entre uma fala e outra é curto, e qualquer pausa longa soa como hesitação ou falha. Num agente de voz, esse tempo é a soma de várias etapas: detectar que o cliente terminou, transcrever, o modelo pensar, consultar um sistema, sintetizar a voz e transmitir o áudio pela rede telefônica.
O que mais reduz a latência percebida:
- Streaming em todas as etapas. A transcrição sai enquanto o cliente fala, o modelo começa a escrever antes de terminar de pensar e a voz começa a ser sintetizada a partir da primeira frase pronta.
- Separar quem fala de quem pensa. O modelo que conduz a conversa pode ser rápido, enquanto outro modelo, com mais capacidade de raciocínio, consulta sistemas e prepara a resposta. O agente avisa que está verificando, como um atendente faria, em vez de ficar em silêncio.
- Modelo do tamanho da tarefa. Confirmar um dado ou cumprimentar não exige o modelo mais potente. Reservar o modelo maior para os passos difíceis reduz tempo e custo.
- Infraestrutura perto do cliente. Processar a chamada em servidores no Brasil evita idas e voltas a outros continentes.
- Integrações rápidas. Uma API lenta no sistema de pedidos vira silêncio na linha. Vale medir o tempo de cada consulta e preparar dados do cliente logo no início da chamada.
Turnos e interrupções
Conversa por voz tem regra de turno: cada um fala na sua vez, e as pessoas se interrompem o tempo todo. Um agente de voz precisa de três capacidades para lidar com isso:
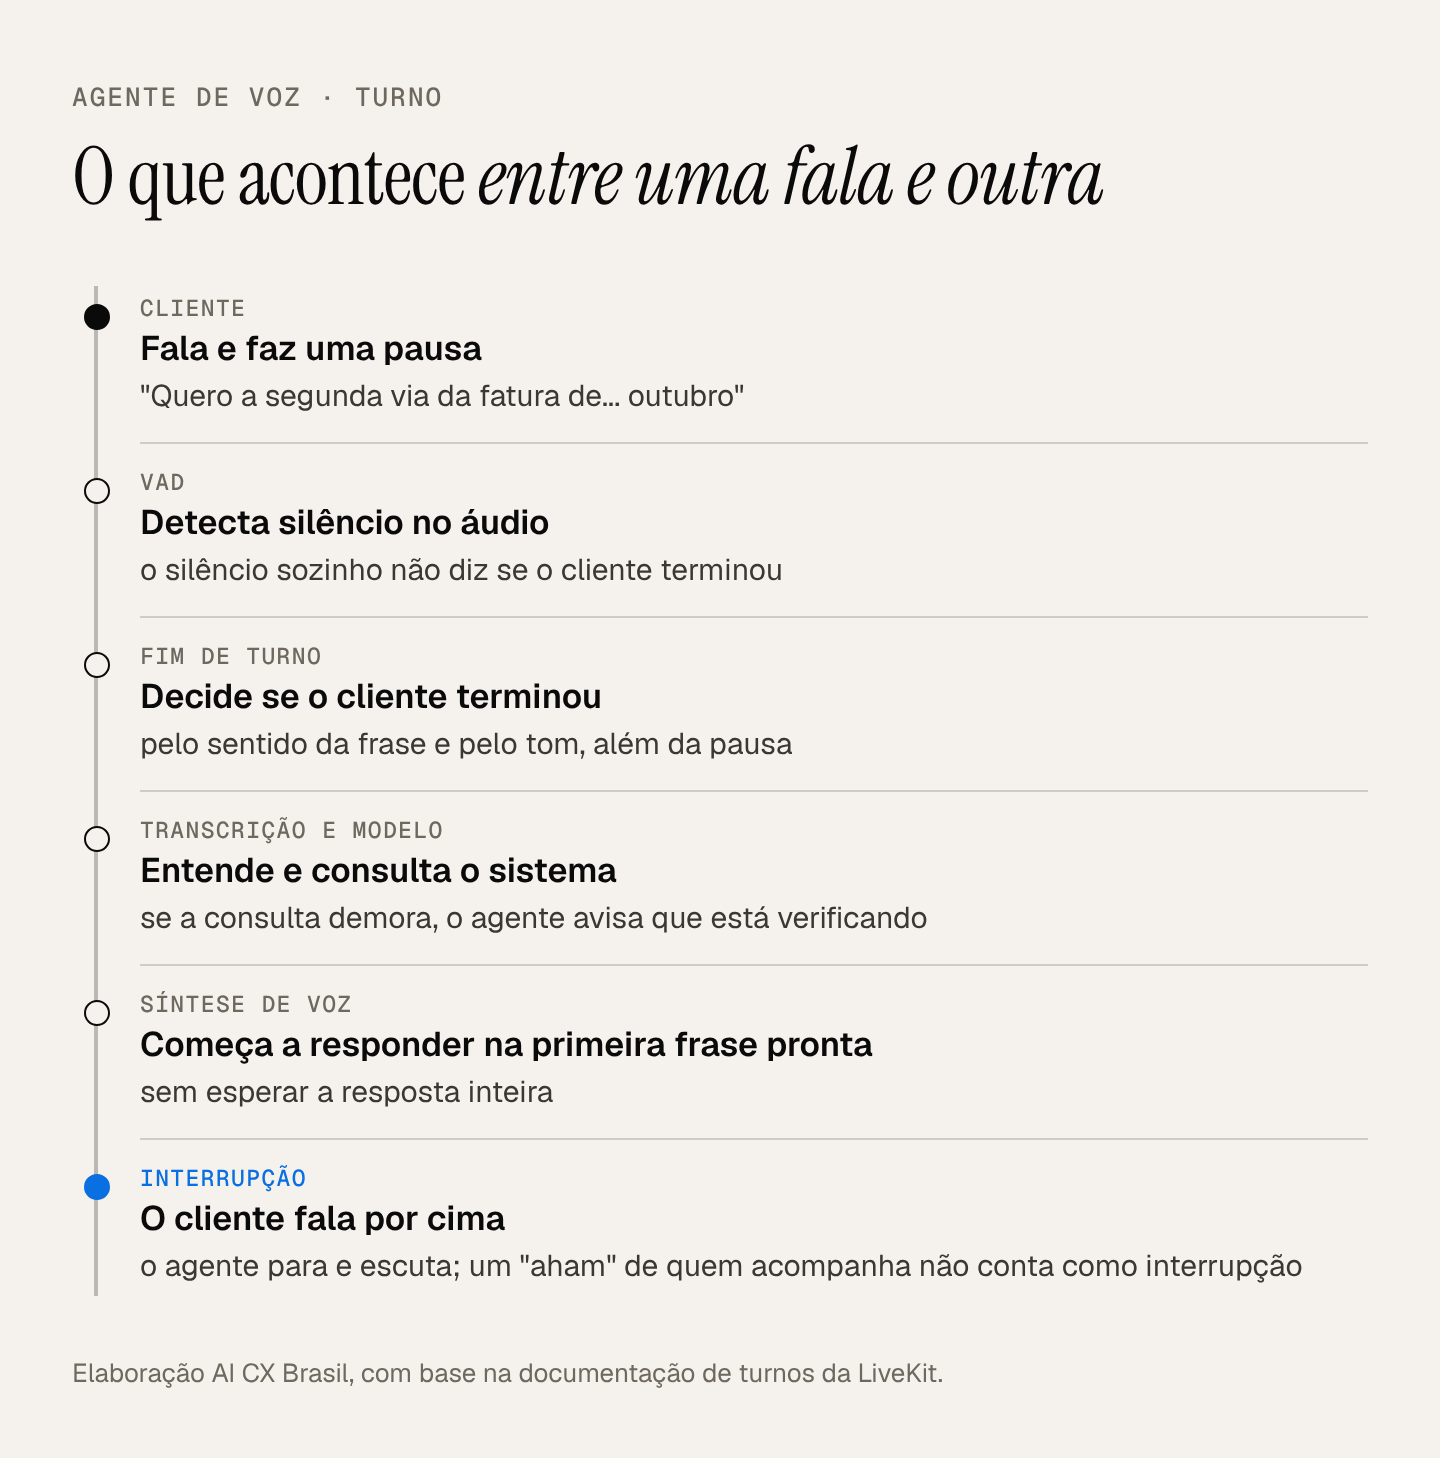
- Detecção de atividade de voz (VAD): identifica quando há fala e quando há silêncio no áudio do cliente.
- Detecção de fim de turno: decide se o cliente terminou ou só fez uma pausa para pensar. A documentação da LiveKit descreve modelos que preveem o fim do turno pelo significado da fala e pelas propriedades acústicas, além do silêncio. Um agente que usa só o silêncio corta o cliente no meio de um número de CPF ou espera demais para responder.
- Interrupção (barge-in): quando o cliente fala por cima, o agente para de falar e escuta. O desafio é separar uma interrupção real de um "aham" ou "sei" de quem só está acompanhando.
Telefonia: a parte que ninguém vê
Boa parte do trabalho de um agente de voz em produção está na telefonia. A linha da empresa costuma passar por operadora, URA, plataforma de contact center, discador e gravação, cada um com sua configuração. Os pontos que exigem decisão:
- Onde o agente entra: no lugar da URA, como uma opção dentro dela ou depois de uma triagem. Em cobrança e outras operações ativas, o agente pode entrar na chamada por conferência com a plataforma que já disca e grava.
- Transferência com contexto: quando passa a ligação para um atendente, o agente envia o resumo do caso para a tela dele. Transferir só o áudio obriga o cliente a repetir tudo.
- Gravação e LGPD: o aviso de gravação, o tempo de guarda, quem acessa e onde o áudio é processado precisam estar definidos antes da primeira chamada.
- Autenticação: confirmar a identidade do cliente por voz, com dados que ele sabe responder sem soletrar uma senha.
- Qualidade da linha: chamada de celular em movimento, ruído de rua e áudio comprimido derrubam a qualidade da transcrição. O agente precisa ser testado nessas condições, além do ambiente silencioso do escritório.
Português brasileiro falado
Agentes de voz costumam funcionar melhor em inglês do que em português, porque a maior parte dos dados e dos testes dos fornecedores é em inglês. Em português brasileiro, alguns cuidados fazem diferença:
- Números, datas e valores: CPF, protocolo, código de barras e valores em reais precisam ser transcritos e falados do jeito certo. Repetir o dado para o cliente confirmar evita erro em cadeia.
- Pronúncia: nomes de produtos, siglas, marcas e palavras em inglês precisam de um dicionário de pronúncia na síntese de voz.
- Sotaques e regionalismos: o reconhecimento de fala deve ser testado com clientes reais de várias regiões, além da equipe do projeto.
- A voz do agente: a voz padrão do fornecedor pode soar artificial ou destoar da marca. A escolha da voz, do ritmo e do tom faz parte do projeto, com teste junto a clientes.
Fluxos determinísticos onde o erro custa caro
Um modelo de linguagem pode errar, e na voz o erro é mais difícil de perceber, porque não fica escrito na tela. Nos passos críticos, o agente segue um caminho controlado: faz perguntas fechadas, classifica a resposta do cliente (sim, não, dúvida, outro assunto), confirma antes de executar e consulta a base de conhecimento antes de afirmar qualquer coisa. Os guardrails definem o que o agente nunca faz por voz, como negociar fora da política ou confirmar uma operação sem a confirmação explícita do cliente.
Um harness para voz e texto
O mesmo agente pode atender por voz, WhatsApp e chat, reaproveitando integrações, regras e base de conhecimento. O comportamento muda por canal. Na voz, as respostas são curtas, sem listas, links ou tabelas, e o agente confirma mais vezes. No texto, ele pode enviar o boleto, o link ou o resumo. Manter um harness único com regras por canal evita que a empresa mantenha dois agentes diferentes que respondem coisas diferentes.
Arquitetura aberta também na voz
Reconhecimento de fala, modelo de linguagem e síntese de voz evoluem em ritmos diferentes, e o melhor fornecedor de cada etapa muda com o tempo. Na arquitetura encadeada, cada componente pode ser trocado sem refazer o agente: um reconhecimento de fala melhor para português, uma voz mais natural ou um modelo mais rápido. Plataformas que entregam as três etapas fechadas num pacote só simplificam o início, mas deixam a empresa presa às escolhas de um único fornecedor em latência, custo e qualidade. O guia sobre agentes de IA detalha essa comparação.
Como medir um agente de voz
Além das métricas de qualquer agente, como resolução, FCR, taxa de transferência, recontato e CSAT, a voz pede métricas próprias:
- Tempo até a primeira palavra: quanto o cliente espera, depois de parar de falar, para ouvir a resposta.
- Interrupções: quantas vezes o cliente precisou falar por cima do agente, e quantas vezes o agente cortou o cliente.
- Repetições: quantas vezes o agente pediu para o cliente repetir, ou repetiu a mesma pergunta.
- Abandono: em que momento da conversa o cliente desligou.
- Erros de transcrição em dados críticos: CPF, valores e datas transcritos errado, conferidos por amostragem das gravações.
Por onde começar
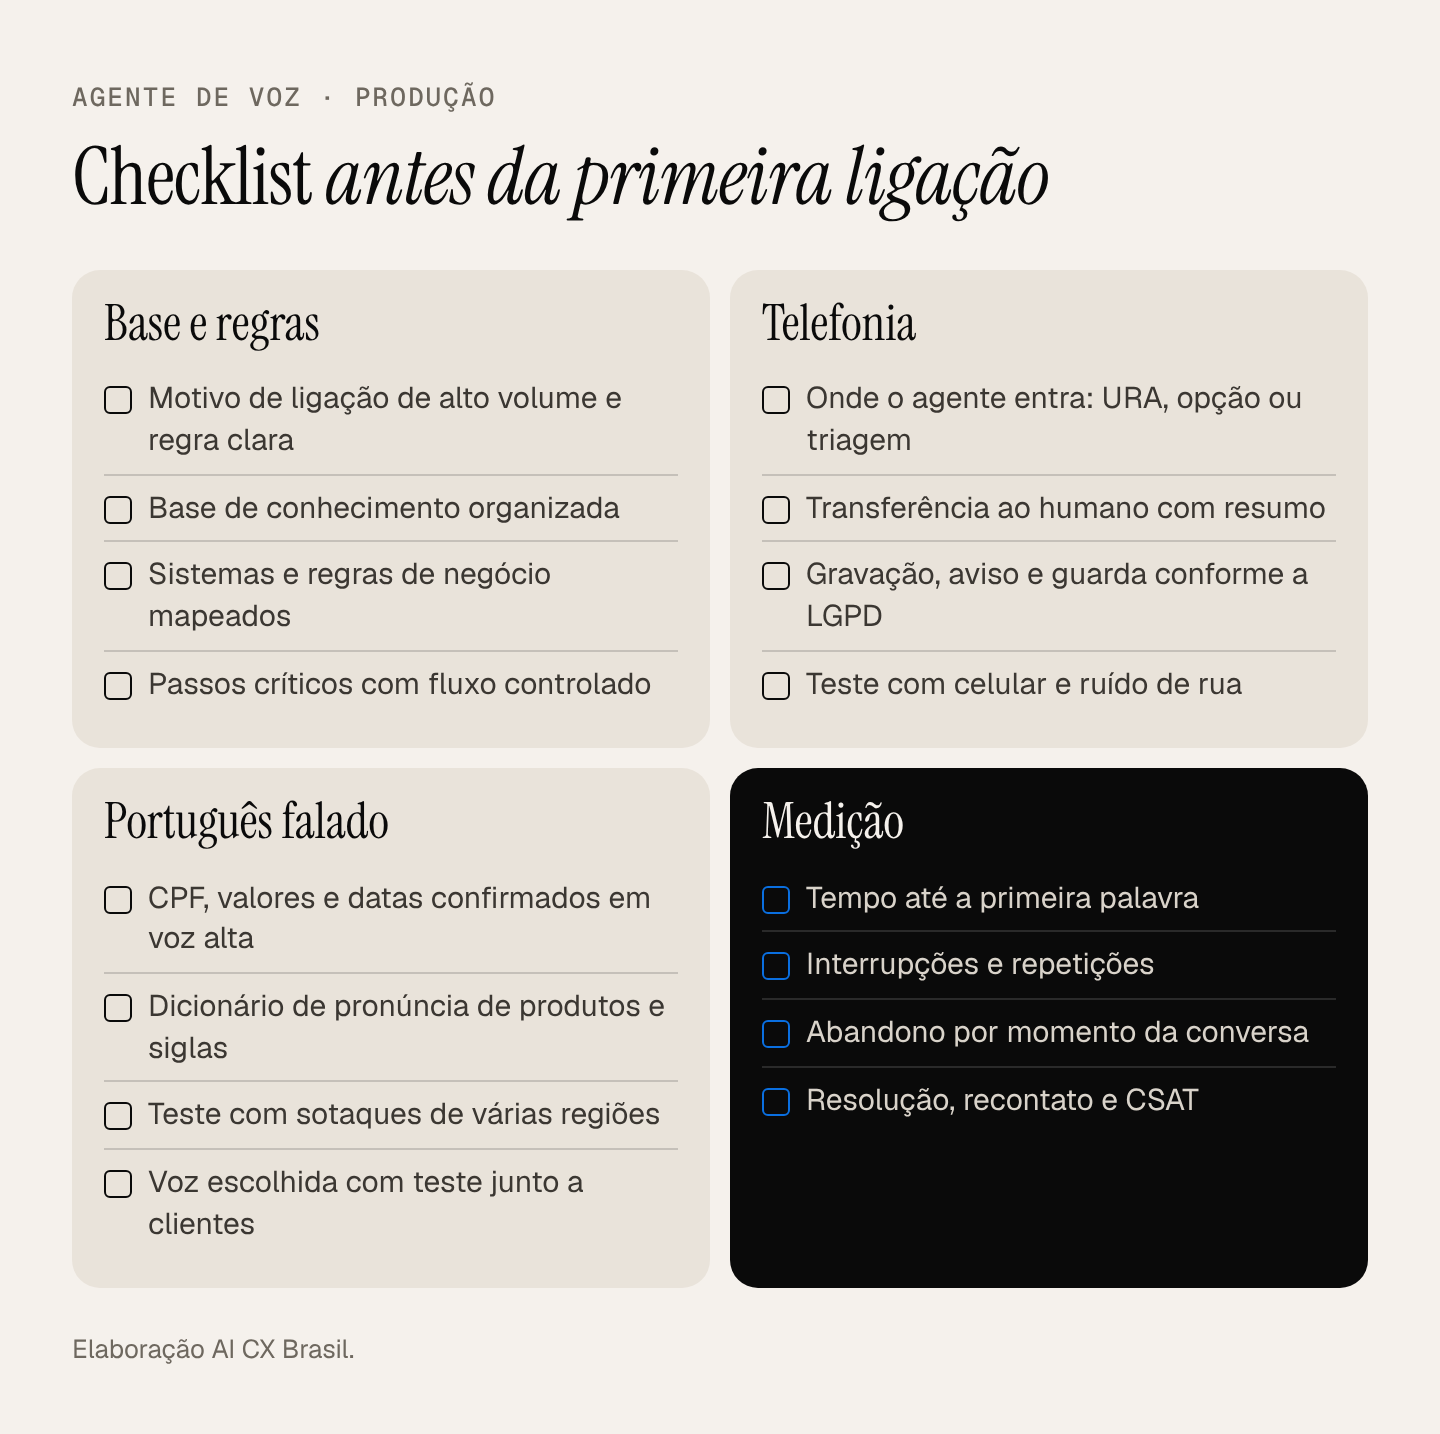
- Escolha um motivo de ligação de alto volume e regra clara, como segunda via ou status de pedido.
- Organize a base de conhecimento e mapeie os sistemas e as regras de negócio que o agente precisa acessar.
- Defina onde o agente entra na telefonia e como transfere para o humano, com contexto.
- Escolha a voz e monte o dicionário de pronúncia, com teste em ligações reais e de várias regiões.
- Meça latência, interrupções, resolução e recontato desde a primeira semana, e amplie aos poucos.
Perguntas frequentes
Qual a diferença entre agente de voz e URA?
A URA tradicional funciona por menu: o cliente digita ou diz uma opção e segue um caminho fixo. O agente de voz conversa em linguagem natural, entende o pedido do jeito que o cliente fala e executa ações nos sistemas da empresa para resolver o caso.
O que é latência num agente de voz?
É o tempo entre o cliente parar de falar e o agente começar a responder. Ela soma a detecção do fim da fala, a transcrição, o modelo, as consultas a sistemas, a síntese de voz e a rede telefônica. Streaming em todas as etapas e modelos do tamanho certo para cada tarefa reduzem esse tempo.
O agente de voz funciona bem em português?
Funciona, mas exige mais cuidado do que em inglês. É preciso testar o reconhecimento de fala com sotaques de várias regiões, confirmar números ditados como CPF e valores e montar um dicionário de pronúncia para produtos, siglas e palavras estrangeiras.
O que acontece quando o cliente interrompe o agente?
O agente precisa parar de falar e escutar. Bons agentes separam uma interrupção real de um sinal de quem só está acompanhando, como um aham, e retomam a conversa a partir do que o cliente disse.
Arquitetura encadeada ou fala a fala: qual escolher?
A encadeada, com reconhecimento de fala, modelo de linguagem e síntese de voz em sequência, dá mais controle: o texto intermediário permite regras, registro e auditoria, e cada etapa pode trocar de fornecedor. A fala a fala tende a soar mais natural e rápida, com menos controle sobre o que acontece no meio.
Fontes
Mais em Guias
O que é um agente de IA no atendimento ao cliente
Como funciona um agente de IA numa central de atendimento, o que é o harness em volta do modelo, por que não depender de um único fornecedor e como saber se o agente está resolvendo o problema do cliente.